Uptime Kuma 설치: Coolify에 Docker 컨테이너로 올려 모니터 11개와 알림을 붙인 기록
Uptime Kuma 설치는 Coolify에 Docker 컨테이너 하나를 올리는 것으로 끝났고, 시간을 쓴 곳은 /health 설계와 알림 설정이었습니다. Docker HEALTHCHECK와 외부 모니터의 역할을 나누고 같은 서버 감시의 한계까지 적었습니다.
목차
flowoodz.com 아래에는 서비스가 여러 개 매달려 있습니다. 브랜드 허브가 apex에 있고, plan.flowoodz.com(Plan Wall), yt.flowoodz.com(Trending Finder), capybara.flowoodz.com에 개인용 자동화 도구 몇 개까지 전부 한 서버의 Coolify 위에서 돌아갑니다. 지난 글에서 허브 배포와 헬스체크 삽질을 정리했는데, 이번 글은 그 다음 단계인 모니터링입니다.
사이드 프로젝트의 문제는 죽어도 아무도 안 알려 준다는 겁니다. 회사 서비스면 온콜이 울리지만, 개인 서버는 내가 어쩌다 접속해 보기 전까지 죽어 있었는지조차 모릅니다. 최악은 사용자가 먼저 발견하는 경우입니다. 이걸 막으려고 Uptime Kuma를 같은 서버에 올렸습니다.
같은 서버에 감시자를 하나 더 올렸습니다#
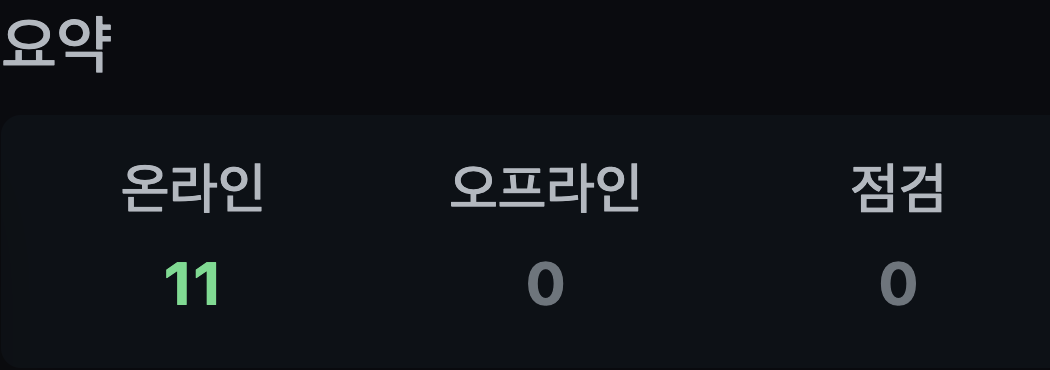
외부 모니터링 SaaS도 물론 있습니다. 무료 티어로 시작할 수 있는 서비스가 여럿인데, 저는 세 가지 이유로 셀프호스팅을 골랐습니다.
- 모니터 개수 제한이 없습니다. 서브도메인이 다섯 개를 넘어가는 시점부터 무료 티어의 모니터 슬롯이 애매해집니다. 서비스를 하나 더 띄울 때마다 모니터링 비용을 계산하고 싶지 않았습니다.
- 서버가 이미 있습니다. Coolify가 돌고 있는 서버에 컨테이너 하나 추가하는 비용은 사실상 0원입니다. Kuma 자체도 전용 서브도메인 하나를 받아 다른 서비스들과 똑같이 올라갔습니다.
- Uptime Kuma는 이 용도의 사실상 표준입니다. 웹 UI에서 HTTP/TCP/핑 모니터를 클릭 몇 번으로 만들고, 응답 키워드 검사, 알림 채널 연동까지 들어 있습니다.
설치는 특별할 게 없었습니다. 다른 앱들과 똑같이 Coolify에 컨테이너로 올리고 서브도메인을 물렸습니다. 데이터는 SQLite 파일 하나로 관리되니 볼륨만 잡아 주면 끝입니다. 처음 접속해서 관리자 계정을 만들고 나면 바로 모니터를 추가할 수 있는 상태가 됩니다.
트레이드오프는 명확합니다. 모니터링이 감시 대상과 같은 서버에 있다는 점입니다. 서버 자체가 통째로 내려가면 Kuma도 같이 죽어서 알림을 못 보냅니다. 이건 뒤에서 다시 다룹니다.
/health는 감시 대상을 하나로 맞추는 계약입니다#
모니터가 칠 경로는 허브 배포 글에서 만든 /health를 그대로 씁니다. 구현 코드를 다시 싣는 대신, 여기서는 이 응답이 무엇을 보장하는지만 구분합니다.
"단순 200 반환이 무슨 헬스체크냐"는 반론이 가능한데, 이 단순함은 따져 보고 고른 결과입니다.
- 이 앱이 확인해야 할 의존성이 없습니다. 브랜드 허브는 DB도 외부 API도 없는 정적에 가까운 Next.js 앱입니다. 이 라우트가 200을 주면 Node 프로세스가 살아 있고, Next 서버가 요청을 라우팅하고 있다는 뜻입니다. 그게 이 앱의 "건강"의 전부입니다.
- DB가 있는 앱이라면 달라져야 합니다. 그때의
/health는 커넥션 풀에서 쿼리 하나를 날려 보고 실패하면 500을 돌려줘야 합니다. "프로세스는 떠 있는데 DB가 끊긴" 좀비 상태를 200으로 포장하는 게 헬스체크의 가장 흔한 거짓말입니다. cache-control: no-store는 필수입니다. 앞단에 Cloudflare 프록시가 있어서, 헬스체크 응답이 캐시에 물리면 죽은 앱도 살아 있는 것처럼 보입니다. 캐시된 "ok"는 모니터링 전체를 무력화합니다.
반대로 넣지 말아야 할 것도 있습니다. 무거운 검사입니다. 헬스체크는 짧은 간격으로 계속 두들겨 맞는 경로라서, 여기에 외부 API 왕복이나 비싼 쿼리를 넣으면 모니터링 자체가 부하 발생원이 됩니다. 인증을 거는 것도 피했습니다. 프로브가 토큰 관리까지 해야 하는 순간 "프로브가 실패한 건지 인증이 만료된 건지"라는 새 미스터리가 생깁니다.
정리하면 원칙은 하나입니다. /health는 그 앱이 일을 할 수 있는 최소 조건을 검사하되, 그 이상은 검사하지 않는다. 의존성이 없으면 200 하나로 충분하고, 있으면 반드시 그 의존성을 건드려 봐야 합니다.
Docker HEALTHCHECK와 Kuma의 역할 분담#
같은 /health를 보는 눈이 둘입니다. Dockerfile의 HEALTHCHECK는 컨테이너 안에서 127.0.0.1:3000/health를 확인하고, Uptime Kuma의 HTTP 모니터는 https://flowoodz.com/health를 외부 도메인 경유로 칩니다. 겹치는 것 같지만 보는 지점이 완전히 다릅니다.
- Docker HEALTHCHECK는 컨테이너 안에서
127.0.0.1:3000을 칩니다. 검사 범위는 "프로세스가 응답하는가"뿐입니다. Coolify가 이 결과로 배포 성공/실패를 판정하고, unhealthy면 롤링 배포를 멈춥니다. 즉 이건 배포 게이트입니다. - Kuma는 밖에서 실제 도메인으로 들어옵니다. DNS 해석, Cloudflare 프록시, TLS, 리버스 프록시 라우팅까지 사용자가 지나가는 전 구간을 통과해야 성공합니다. 컨테이너가 healthy여도 DNS 레코드가 잘못됐거나 프록시 설정이 깨지면 Kuma만 잡아냅니다. 이건 가용성 감시입니다.
지난 글에서 겪은 것처럼 alpine 이미지에 wget이 없으면 HEALTHCHECK 쪽만 조용히 전멸하는데, 이때도 Kuma는 멀쩡히 초록불이었을 겁니다. 반대로 Cloudflare 설정 실수는 HEALTHCHECK가 절대 못 봅니다. 둘 중 하나만 있으면 반쪽입니다.
모니터는 서비스마다 하나씩 만들었습니다. /health 라우트가 있는 앱은 그 경로를, 없는 서비스는 루트 URL을 봅니다. 허브 모니터라면 이런 식입니다.
Monitor Type : HTTP(s) - Keyword
URL          : https://flowoodz.com/health
Keyword      : ok
단순 HTTP 모니터 대신 Keyword 타입을 쓰면 상태 코드만이 아니라 응답 본문에 ok가 들어 있는지까지 봅니다. 리버스 프록시가 자기 에러 페이지를 200으로 돌려주는 식의 엣지 케이스를 걸러 주기 때문에, 본문을 평문으로 고정해 둔 /health와 궁합이 좋습니다. 그리고 새 서비스를 올릴 때의 체크리스트에 "Kuma 모니터 추가"가 배포 문서의 한 줄로 들어가 있습니다. 모니터 추가를 습관이 아니라 절차로 만들어 두지 않으면, 제일 최근에 올린 서비스가 항상 감시 사각지대가 됩니다.
알림 없는 모니터링은 대시보드일 뿐#
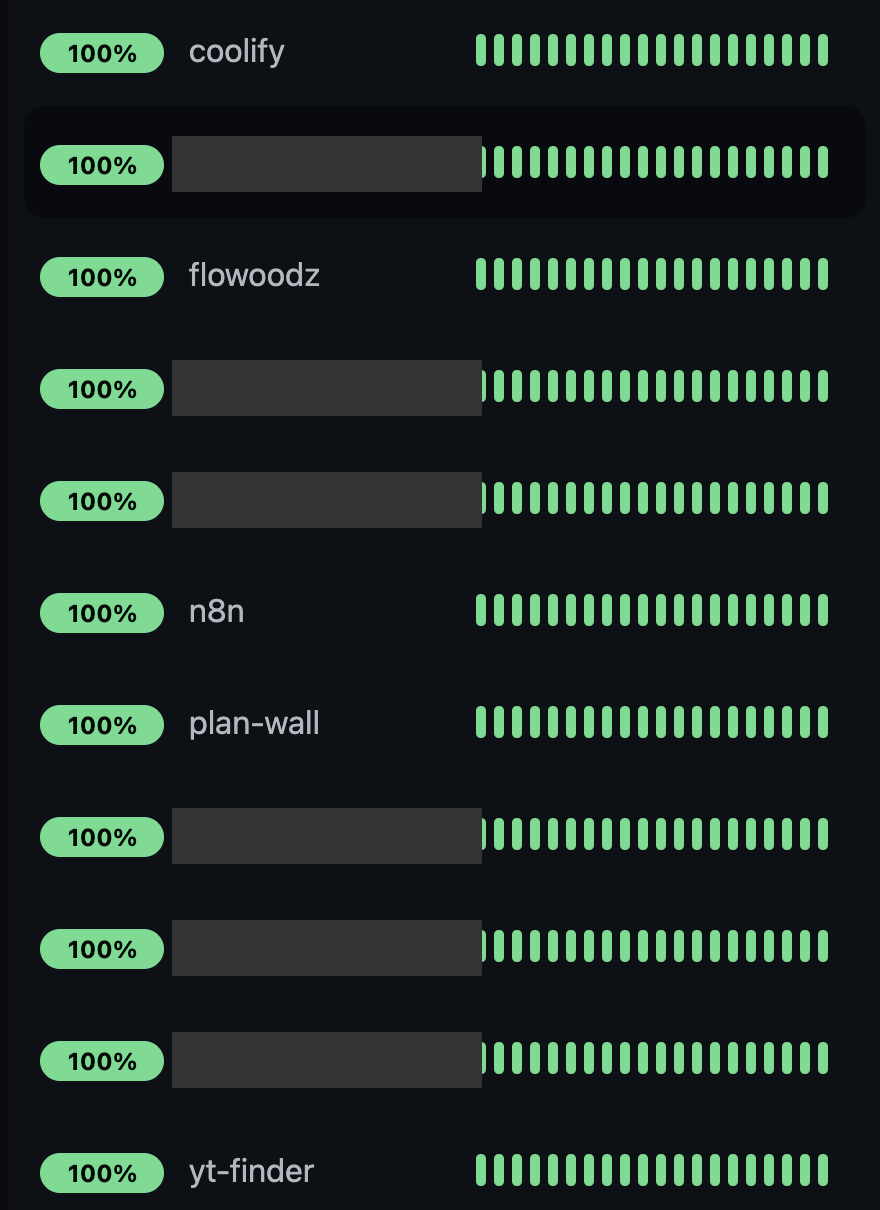
일부 모니터 이름은 가렸습니다. 공개한 서비스가 아닌 것까지 이름을 드러낼 이유가 없어서입니다.
Kuma 대시보드가 아무리 예뻐도 내가 안 보면 소용이 없습니다. 사이드 프로젝트 모니터링의 실패 패턴은 대시보드까지 만들어 놓고 알림을 안 붙이는 겁니다. 결국 죽은 걸 발견하는 경로가 "어쩌다 접속"으로 되돌아갑니다.
Kuma는 모니터별로 알림 채널을 붙일 수 있고 Telegram, Slack, Discord, 이메일, webhook 등 웬만한 채널은 다 지원합니다. 붙일 때 기본값 그대로 쓰지 말고 두 가지는 조정하는 게 좋습니다.
- Retries를 1 이상으로. 홈 서버는 순간적인 네트워크 흔들림이 있습니다. 첫 실패에 바로 쏘면 새벽에 오탐으로 깨는 알림함이 됩니다. 연속 실패가 확인될 때만 울리게 합니다.
- 복구 알림도 켜기. down 알림만 받으면 "지금도 죽어 있나?"를 확인하러 결국 대시보드에 들어가야 합니다. up 복구 알림이 와야 루프가 닫힙니다.
알림 채널은 하나만 설정해 두면 이후에 만드는 모든 모니터에 재사용됩니다. 채널을 고를 때의 기준은 단순합니다. 내가 어차피 하루 종일 보고 있는 곳이어야 합니다. 안 보는 이메일함으로 보내는 알림은 대시보드와 다를 게 없습니다.
그리고 앞서 말한 구조적 한계. Kuma가 감시 대상과 같은 서버에 있으므로, 서버가 통째로 죽는 시나리오는 이 구성이 못 잡습니다. Kuma가 죽으면 알림 주체가 없으니까요. 이건 외부에서 Kuma 자체(혹은 아무 서비스나 하나)를 찔러 주는 바깥 감시자가 하나 있어야 닫히는 구멍입니다. 완벽하지 않다는 걸 알고 쓰는 것과 모르고 쓰는 것은 다릅니다.
사용자보다 먼저 알기 위한 조건#
- 모니터링의 목적은 대시보드가 아니라 "사용자보다 먼저 아는 것"입니다. 알림 채널까지 붙어야 완성이고, retries와 복구 알림 설정이 알림의 품질을 결정합니다.
/health는 앱의 최소 노동 조건만 검사합니다. 의존성 없는 앱은 평문ok면 충분하고, DB가 있으면 반드시 DB를 건드려야 합니다. 프록시 뒤라면no-store는 협상 대상이 아닙니다.- Docker HEALTHCHECK와 외부 모니터는 대체재가 아니라 상호보완입니다. 하나는 배포 게이트(컨테이너 내부), 하나는 가용성 감시(사용자 경로 전 구간). 같은 엔드포인트를 두 각도에서 봅니다.
- 같은 서버 위의 모니터링은 서버 전체 장애에 눈이 멉니다. 이 한계는 바깥 감시자 하나로 보완해야 합니다.
서비스를 하나 올릴 때마다 모니터 하나를 같이 만드는 습관이 생겼습니다. 죽는 건 막을 수 없지만, 죽은 걸 사용자보다 늦게 아는 건 막을 수 있습니다.